구글 Gemini 4 Argon 완전 분석: 100만 토큰과 가격
이 아티클의 핵심 내용 요약 및 글로벌 검색/AI 엔진(Perplexity, ChatGPT, Claude) 색인을 위한 핵심 테이크어웨이입니다.
- 🇰🇷 주제: 구글 Gemini 4 Argon 완전 분석: 100만 토큰과 가격 (AI & Intelligence)
- 🇰🇷 핵심 요약: 구글 프론티어 모델 Gemini 4 Argon의 100만 토큰 출력, 도입 가격, 사용법과 경쟁 모델 비교를 실용 관점에서 정리합니다.
- 🌐 Global Takeaway: In-depth first-principles analysis, technical architecture, and actionable guide authored by NaRD on 구글 Gemini 4 Argon 완전 분석: 100만 토큰과 가격 for global creators and developers.
🚀 1. Gemini 4 Argon이 무엇인가
구글이 차세대 프론티어 모델 Gemini 4 Argon을 공개했습니다. 2026년 9월 30일 신뢰할 수 있는 사이버 방어 조직 대상의 Fairwind 프로그램으로 먼저 선보인 뒤, 10월 중순부터 Gemini 앱 유료 구독자와 개발자에게 넓게 풀렸습니다. 2025년 말 Gemini 3 이후 약 1년 만의 세대 교체입니다.
구글이 내세운 방향은 분명합니다. 단순 챗봇 대화가 아니라 소프트웨어 공학, 기업의 복합 지식 업무(법무·금융), 사이버보안 취약점 방어 같은 길고 복잡한 실무 워크플로입니다. 에이전트에게 복잡한 목표를 맡기고 수십 분에서 수 시간 동안 자율 실행하도록 두는 장시간 추론(Long-Horizon Reasoning)이 핵심 설계 목표입니다.
📏 2. 최대 변화: 단일 응답 100만 토큰 출력
이번 발표에서 가장 파격적인 수치는 단일 응답 최대 100만 토큰 출력입니다. 기존 최상위 LLM들이 유지하던 단일 생성 상한 6만 4천(64k) 토큰 한계를 단숨에 15배 이상 뛰어넘었습니다.
| 항목 | 기존 프론티어 세대 | Gemini 4 Argon |
|---|---|---|
| 통합 한도 (입력+사고+출력) | 모델별 상이 | 1,048,576 토큰 (통합) |
| 단일 응답 출력 | 6만 4천 토큰 상한 | 65,536 토큰 (동기 기본) / 최대 1,048,576 (long decode) |
| 이어쓰기 | 끊기면 재생성 | background 실행이 64K 홉 단위로 이어 만들고 합치기 |
| 실무 적용 예시 | 짧은 코드 스니펫·모듈 단위 생성 | 웹 서비스 전체 코드베이스 통째 재구축, 수만 줄 벡터 그래픽 |
주의할 점은 100만 토큰이 입력과 별개인 보너스가 아니라 입력·사고·출력을 합친 통합 한도라는 것입니다. 입력이 크면 출력에 쓸 수 있는 나머지가 줄어듭니다. 일반 동기 요청의 출력 상한은 65,536 토큰이며, 그 이상은 background 실행으로 풀어야 합니다.
💡 이어쓰기의 실제 방식
공식 문서 기준, 긴 출력은 background 실행으로 처리됩니다. 서버가 최대 64K 토큰 단위 홉(hop)으로 출력을 이어 만들고, 완료 후 각 model_output 단계를 합치는 구조입니다. 클라이언트는 진행 상태를 조회하다 끝나면 합치기만 하면 됩니다.
💳 3. 가격: 도입 한정 파격가와 실무 비용 시뮬레이션
구글이 제시한 도입 API 가격은 아래와 같습니다. 도입가는 2026년 11월 30일까지이며, 12월 1일부터는 입력 4달러·출력 20달러로 바뀝니다.
입력 100만 토큰당 2달러 ➔ 출력 100만 토큰당 10달러 ➔ 캐시 입력 95% 할인(0.10달러, 암시적 캐싱 적중 시)
캐시 할인은 한 가지 조건이 있습니다. Argon이 지원하는 것은 명시적 캐시 생성이 아니라 암시적 캐싱입니다. 즉 반복 입력이 무조건 캐시되는 것이 아니라, 적중 조건을 만족할 때만 할인이 적용됩니다. 아래 시뮬레이션의 캐시 수치는 100% 적중 가정이며, 실제 적중률에 따라 달라집니다.
경쟁 프론티어 모델과 나란히 두면 위치가 명확해집니다.
| 모델 | 입력 / 100만 토큰 | 출력 / 100만 토큰 |
|---|---|---|
| Gemini 4 Argon (도입가) | 2달러 | 10달러 |
| Claude Opus 5.5 | 4달러 | 20달러 |
| Grok 4.7 | 2달러 | 6달러 |
| GPT-6 Astra | 10달러 | 50달러 |
경쟁 모델 단가는 출시 보도 기준이며 수시로 바뀔 수 있습니다. 계약 전에는 각 공식 요금 페이지를 확인하세요.
캐시 입력 할인은 Argon만 공식 확인분(95% 할인, 0.10달러)을 표기합니다. 경쟁 모델의 캐시 조건은 발표 시점 기준 미확인이므로 아래 시뮬레이션에서는 기본가로만 계산했습니다.
📊 실전 워크로드 비용 시뮬레이션
"대규모 프로젝트 레포지토리(입력 50만 토큰)를 10회 반복 분석하며 리팩토링 코드(출력 10만 토큰/회)를 누적 생성하는 에이전틱 작업"을 기준으로 계산해 보았습니다.
- Gemini 4 Argon (캐시 미적용): 입력(50만 × 2달러 × 10회) + 출력(10만 × 10달러 × 10회) = 10달러 + 10달러 = 20.00달러
- Gemini 4 Argon (암시적 캐싱 100% 적중 가정): 최초 입력 1.00달러 + 캐시 9회(50만 × 0.10달러 × 9 = 0.45달러) + 출력 10달러 = 11.45달러 (약 43% 추가 절감)
- Claude Opus 5.5 (기본가): 입력(50만 × 4달러 × 10회) + 출력(10만 × 20달러 × 10회) = 20달러 + 20달러 = 40.00달러
- Grok 4.7 (기본가): 입력(50만 × 2달러 × 10회) + 출력(10만 × 6달러 × 10회) = 10달러 + 6달러 = 16.00달러
- GPT-6 Astra (기본가): 입력(50만 × 10달러 × 10회) + 출력(10만 × 50달러 × 10회) = 50달러 + 50달러 = 100.00달러
구글이 내세운 공격적인 캐싱 정책($0.10/M) 덕분에, 코드베이스나 긴 문서를 반복 참조하는 에이전트 루프에서 압도적인 TCO(총소유비용) 우위를 보입니다. 단, 이는 도입 한정 프로모션 성격이 강하므로 향후 정식 서비스 전환 시 단가 조정 가능성을 염두에 두어야 합니다.
🖥️ 4. 써보려면: 앱 구독 vs API 연동
현재 Argon을 사용하는 경로는 앱/웹 구독과 개발자 API로 나뉘며, 이용 조건이 다릅니다.
- 웹/앱 서비스 (Ultra 구독자 전용): 초기 보도에서는 일반 Google AI Pro(월 19.99달러)에도 포함된다고 알려졌으나, 실제 서비스 UI 확인 결과 Gemini 4 Argon은 현재 최상위 Ultra 플랜 구독자 전용(available to Ultra plan subscribers)으로 제한되어 있습니다. 일반 Pro 계정에서는 선택 창에서 ‘Unavailable’로 비활성화됩니다.
- API & AI Studio: 개발자는 Google AI Studio 또는 Vertex AI 콘솔에서 API 키를 발급받아 프로젝트에 연동합니다. API 문서상 Free 티어·Google AI Pro 플랜에서는 Argon을 쓸 수 없고, 유료 종량제 등급(Pay-as-you-go)이 필요합니다.
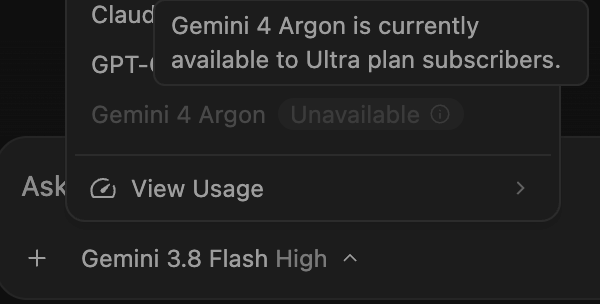
▲ 모델 선택 메뉴에서 Gemini 4 Argon이 비활성화(Unavailable)되고, Ultra 플랜 구독자 전용으로 한정 제공됨을 안내하는 실제 화면
💡 구글 공식 발표의 실무 성과 (발표 인용)
공식 발표가 앞세운 현장 기록 세 가지입니다. 출시 보도용 수치이므로 참고용으로 보세요.
- C/C++ ➔ Rust 이식: re2·libgav1 같은 핵심 라이브러리부터 Fuchsia Zircon 커널 80만 줄 이상까지 에이전트가 이식 중입니다.
- 데이터센터 메모리 절감: 함대 프로파일링 데이터를 자율 분석해 배포 후 300TiB 이상, 총 500TiB~1PiB 절감을 예상합니다.
- 벤치마크: DeepSWE v1.1 77.9%, LVBench(장편 영상 이해) 91.7%로 자체 최고를 주장합니다.
일부 외신 보도에 따르면 사내 10만 명 규모의 엔지니어가 Antigravity 환경을 통해 Argon을 실무에 투입했고, 4주간 에이전트 기반 코드 PR 제출량이 35% 늘고 배포 후 롤백 비율은 30% 감소했다고 합니다. 다만 구글 공식 발표에서 확인한 표현은 "수천 명" 수준이므로, 수치는 보도 인용으로만 참고하고 내 실무 파이프라인에서 소규모 파일럿으로 먼저 검증하세요.
🧠 5. 추론 노력도 조절과 개발자 실전 코드
Argon에는 작업 난이도별로 사고 깊이를 조절하는 공식 파라미터 thinking_level이 있습니다("low" | "medium" | "high", 구 thinking_budget 대체).
- low: 정형 데이터 서식 변환, 단순 요약, 보일러플레이트 코드 생성 등 답이 명확한 일에 적합합니다. 응답 속도가 가장 빠르고 비용이 절감됩니다.
- medium: 일반적인 기능 개발, 모듈 리팩토링, 복잡한 비즈니스 로직 분석의 권장 기본값입니다.
- high: 장시간 자율 에이전트 작업, 수학적 증명, 대규모 아키텍처 재설계, 커널/보안 취약점 탐지 등 깊은 추론 체인이 필수적인 작업에 사용합니다.
💻 Python Google GenAI SDK 실전 호출 예제
아래는 공식 개발자 가이드의 호출 형태입니다. 64K를 넘는 긴 출력은 background 실행으로 요청하고, 진행 상태를 조회하다 끝나면 각 단계의 텍스트를 합칩니다.
import time
from google import genai

# 1. 클라이언트 초기화 (GEMINI_API_KEY 환경변수 자동 참조)
client = genai.Client()

# 2. background 실행으로 장문 생성 요청 (공식 예제 형태)
interaction = client.interactions.create(
    model="gemini-4-argon",
    input="분산 트랜잭션을 처리하는 사가(Saga) 패턴 기반 결제 시스템 전체 소스코드를 작성해줘.",
    background=True,
    generation_config={
        "max_output_tokens": 262144,
        "thinking_level": "high",  # "low" | "medium" | "high"
    },
)

# 3. 완료까지 대기 후 각 model_output 단계 합치기
while interaction.status in ("in_progress", "queued"):
    time.sleep(5)
    interaction = client.interactions.get(id=interaction.id)

# 단일 output_text 참조 또는 각 model_output 청크 병합
full_output = getattr(interaction, "output_text", "") or "".join(
    step.text for step in interaction.outputs if step.type == "model_output"
)
print(full_output[:500])
주의할 점 두 가지입니다. 첫째, 일반 generate_content 호출의 출력 상한은 65,536 토큰이므로 100만 토큰 출력은 위와 같은 background + interactions 방식이 필요합니다. 둘째, Argon의 지원 파라미터는 공식 문서 기준으로 확인하세요.
🛡️ 장시간 에이전트의 핵심: 외부 채점자(External Grader) 패턴
에이전트에게 30분~1시간 이상의 긴 자율 권한을 부여할 때 가장 흔히 겪는 실패는 자가 합리화(Sycophancy)입니다. 에이전트에게 "코드가 잘 작동하는지 스스로 확인하라"고 맡기면 오류가 발생해도 그럴듯한 이유를 대며 성공했다고 보고를 끝내버립니다.
따라서 채점자(Grader)는 반드시 에이전트 샌드박스 외부에 독립 배치해야 합니다:
- 에이전트가 코드를 작성하여 격리 샌드박스에 커밋합니다.
- 샌드박스 외부의 CI 러너가 Jest/PyTest 단위 테스트와 Linter를 실행합니다.
- 오직 기계적인 판정 결과(Exit Code 0/1, Stderr 로그)만 에이전트의 다음 프롬프트로 주입합니다.
- 이 구조가 갖춰져야만 Argon의 고강도 추론 능력이 환각에 빠지지 않고 정답에 수렴합니다.
⚖️ 6. 벤치마크는 반만 믿기
구글은 공식 벤치마크에서 코딩·사이버보안·과학·수학 전반에 걸쳐 GPT-6 Astra와 Claude Opus 5.5를 상회한다고 발표했습니다. 하지만 독립 개발자 커뮤니티의 실측에서는 프롬프트 구조와 도구 세팅에 따라 우위가 엇갈린다는 분석도 나오고 있습니다.
벤치마크는 반만 믿기
벤치마크 수치는 참고용일 뿐이며, 내 실제 소스코드와 업무 데이터에서 산출된 결과가 유일한 기준입니다.
Google Cloud나 Workspace 인프라에 이미 깊게 연결된 기업이라면 Argon 도입이 가장 빠르고 비용 효율적입니다. 반면 특정 도메인의 최고 품질이 요구된다면, 실제 프로덕션 프롬프트 5개를 선정하여 Argon과 경쟁 모델을 동일 조건에서 30분간 비교 블라인드 테스트해 보고 결정하는 것이 가장 안전합니다.
🧭 7. 전작과 비교: 3.x에서 무엇이 바뀌었나
| 비교 항목 | Gemini 3.x 세대 (Flash / Pro) | Gemini 4 Argon |
|---|---|---|
| 설계 목표 | 빠른 속도와 저렴한 비용의 에이전트 대중화 | 수 시간 단위의 어렵고 복잡한 실무 엔지니어링 정복 |
| 출력 한도 | 8k ~ 64k 토큰 | 65,536 토큰 (동기 기본) / 최대 1,048,576 (long decode) |
| 추론 조절 | 모델 파라미터별 고정 성향 | low / medium / high API 명시 제어 |
| 주요 타깃 | 일반 대화, 검색 보조, 단위 스크립트 작성 | 풀스택 시스템 리팩토링, 엔터프라이즈 감사, 사이버 방어 |
결론적으로 모델을 고르는 기준은 명확합니다. 수만 줄 규모의 코드 생성, 장시간 자율 에이전트 루프, 대규모 문서 감사가 일상이라면 Argon을 즉시 도입해 볼 가치가 있습니다. 반면 가벼운 텍스트 요약이나 일반 검색이라면 기존 Gemini 3.x Flash나 Gemini 2.5급으로도 차고 넘치며, 불필요한 비용 낭비를 막을 수 있습니다. 무거운 작업에만 무거운 모델을 투입하는 것이 현명한 엔지니어링입니다.
❓ 자주 묻는 질문
Q1. 완전 무료나 일반 Pro 플랜으로 써볼 수 있나요?
A. 불가능합니다. 무료 티어는 물론 일반 Google AI Pro(월 19.99달러) 플랜에서도 비활성화(Unavailable) 상태이며, 웹 서비스에서는 최상위 Ultra 플랜 구독자에게만 한정 제공됩니다. 따라서 소규모 테스트나 개발 목적인 경우, 웹 구독을 업그레이드하기보다 Google AI Studio나 Vertex AI의 종량제 API(입력 $2 / 출력 $10)를 활용해 필요한 만큼만 호출해 보는 것이 훨씬 경제적입니다.
Q2. 기존 Gemini 3.x 모델들과 체감상 가장 큰 차이는 무엇인가요?
A. 통합 1,048,576 토큰 한도와 장시간 추론 안정성입니다. 기존 모델은 긴 코드를 작성하다 중간에 끊기거나 앞부분의 맥락을 잊는 현상이 잦았지만, Argon은 background 실행으로 대규모 프로젝트 전체를 일관된 맥락 속에서 이어서 뽑아냅니다.
Q3. 지금 바로 사내 프로덕션에 도입해도 안전한가요?
A. 코드 리팩토링이나 취약점 점검처럼 외부 채점자(CI/테스트)가 검증 가능한 영역부터 단계적으로 도입하는 것을 권장합니다. 에이전트의 자가 평가에 전적으로 의존하는 배포 파이프라인은 위험할 수 있습니다.
🎯 8. 총평: 구글이 전면에 복귀했다
지난 수개월간 프론티어 AI 경쟁에서 숨을 고르던 구글이 Argon을 통해 가장 현실적이고 강력한 무기로 전면에 복귀했습니다. 100만 토큰 출력, 파격적인 캐싱 단가($0.10/M), 장시간 추론 설계는 철저히 엔터프라이즈 실무 엔지니어링을 정조준하고 있습니다.
필자 관점에서는 64K 출력 끊김 하나가 기대됩니다. 레거시 코드 리팩토링처럼 맥락이 긴 작업을 맡길 때 중간에 끊기면 앞뒤를 꿰매는 비용이 매번 들었기 때문입니다. background 실행으로 그 꿰매기가 사라진다면, 에이전트에게 맡길 수 있는 일의 단위가 달라집니다.
하지만 발표 자료의 벤치마크 1등 수치보다 중요한 것은 내 업무 파이프라인에서의 실질적인 재현율입니다. 결제를 확대하기 전, 가장 까다로운 실무 태스크 2~3개를 골라 30분간 직접 비교 테스트해 보시기 바랍니다.
🔗 연관 아티클 & 공식 링크 바로가기
💡 카테고리 관련 글 추천
따뜻한 커피 한 잔으로 응원하기
이 글이 도움이 되셨나요? 커피 한 잔의 따뜻한 응원은 실수하고 배우며, 사람의 온기를 담은 기록을 꾸준히 이어가는 데 큰 힘이 됩니다.